Формирование «цифрового атласа знаний» бренда — это стратегический подход к организации контента, который позволяет ИИ-системам (поисковым ассистентам, чат-ботам) давать исчерпывающие и точные ответы о вашей компании, продуктах или услугах. Это не просто набор FAQ или глоссарий, а целостная, взаимосвязанная база данных, специально оптимизированная для автоматизированного извлечения и синтеза информации. Создание такого атласа — фундамент успешной ответной оптимизации (AEO) и оптимизации для генеративных систем (GEO), что прямо влияет на видимость и доверие к бренду в эпоху доминирования ИИ-поиска.
Что такое «цифровой атлас знаний» и зачем он нужен
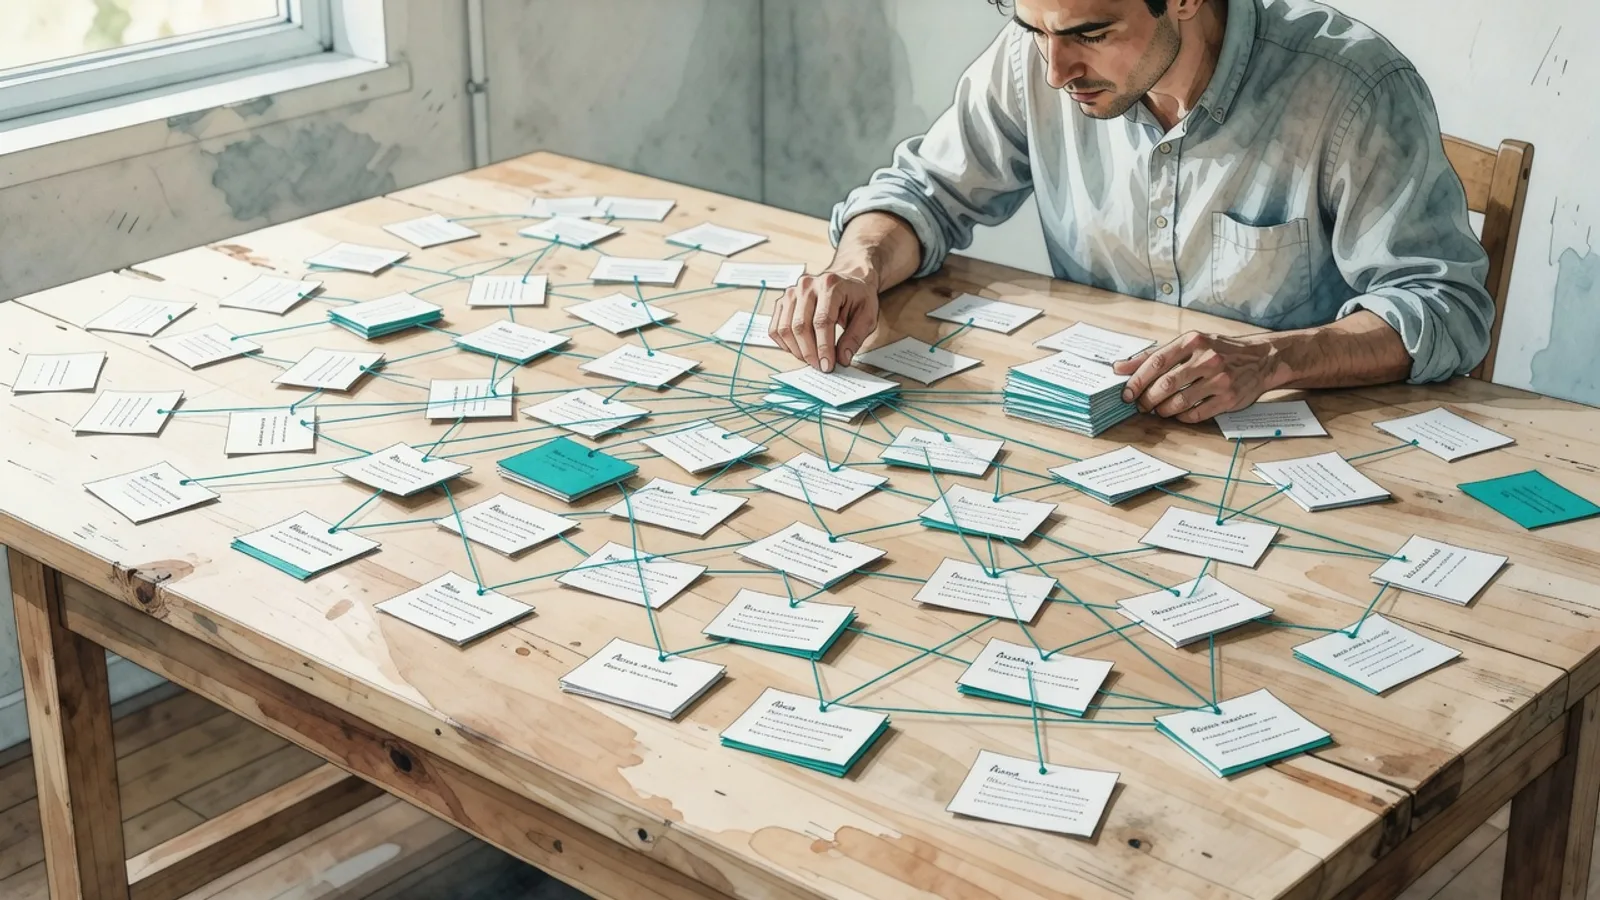
«Цифровой атлас знаний» — это централизованная, структурированная и постоянно обновляемая база данных, содержащая всю релевантную информацию о вашем бренде, его продуктах, услугах, истории, миссии, ценностях и ответах на типовые вопросы. Это не просто коллекция документов, а сеть взаимосвязанных фактов и сущностей, представленных в машиночитаемом формате. Представьте его как внутреннюю энциклопедию бренда, которую может «прочитать» не только человек, но и ИИ-система.
Основная задача атласа — минимизировать «галлюцинации» ИИ и обеспечить ему доступ к единственно верной, официальной информации. Когда пользователь задает вопрос поисковому ассистенту или чат-боту, ИИ ищет ответы не только по ключевым словам, но и по смысловым связям. Если ваша информация разрознена, противоречива или не структурирована, ИИ вынужден достраивать контекст из других источников, что часто приводит к неточностям. Атлас знаний устраняет эту проблему, предоставляя единый источник истины.
Более того, атлас позволяет создавать комплексные ответы, комбинируя несколько фрагментов информации. Например, на вопрос «Каковы преимущества продукта X и как его купить?» ИИ может дать не просто описание характеристик, но и интегрировать информацию о доставке, гарантии и ближайших точках продаж — всё из одного надежного источника.
Ключевые преимущества для бренда
- Повышение точности ИИ-ответов: исключает домыслы и неверные интерпретации.
- Улучшение пользовательского опыта: пользователи получают быстрые, полные и релевантные ответы.
- Увеличение видимости в ИИ-поиске: структурированная информация лучше ранжируется и чаще используется для формирования прямых ответов.
- Сокращение нагрузки на поддержку: многие вопросы будут решаться автоматически через ИИ-ассистентов.
- Формирование экспертного имиджа: бренд воспринимается как надежный и авторитетный источник информации.
Архитектура «цифрового атласа знаний»: основные компоненты
Создание эффективного цифрового атласа требует системного подхода. Он состоит из нескольких взаимосвязанных слоев, каждый из которых играет свою роль в оптимизации для ИИ.
Семантическое ядро и онтологии
В основе атласа лежит семантическое ядро, то есть полный набор сущностей (продуктов, услуг, функций, преимуществ, проблем клиентов) и их взаимосвязей. Для этого необходимо провести глубокий анализ информационного ландшафта бренда. Онтологии — это формальное представление этих сущностей и связей, которое позволяет машине «понимать» смысл данных. Например, онтология для B2B-компании может включать сущности «Продукт», «Клиент», «Отрасль», «Кейс-стади», «Решение», а также связи типа «Продукт используется Клиентом в Отрасли для Решения Проблемы».
Разработка онтологии — сложный, но критически важный этап. Начинайте с определения ключевых сущностей, которые описывают ваш бизнес. Затем выстраивайте иерархию и связи между ними. Чем детальнее и логичнее выстроены эти связи, тем легче ИИ будет извлекать нужную информацию и строить на её основе сложные ответы. Примеры таких связей: «X входит в состав Y», «X является альтернативой Y», «X решает проблему Z», «X предназначен для аудитории W».
Структурированные данные и разметка Schema.org
Сами данные должны быть представлены в структурированном формате. Для этого используются стандарты разметки, такие как Schema.org. Это микроразметка на вашем сайте, которая прямо указывает поисковым системам, что представляют собой те или иные элементы контента. Например, вы можете разметить информацию о продукте (Product), организации (Organization), FAQPage, HowTo, Article, Event и так далее. Использование Schema.org значительно повышает вероятность того, что ваш контент будет использован ИИ для формирования информационных блоков и прямых ответов.
- Product: название, цена, описание, характеристики, отзывы.
- Organization: адрес, контакты, логотип, тип организации.
- FAQPage: вопросы и ответы.
- HowTo: пошаговые инструкции.
- Article: дата публикации, автор, тематика.
Разметка должна быть последовательной и полной. Не стоит ограничиваться базовыми типами. Чем больше релевантных атрибутов вы разметите, тем глубже ИИ сможет «понять» ваш контент. Это особенно актуально для GEO, где генеративные модели активно используют семантические связи для создания связных и информативных текстов.
Контентные сущности и их атрибуты
Каждая единица контента — статья, страница продукта, кейс — должна рассматриваться как отдельная сущность в атласе. Для каждой такой сущности необходимо определить набор атрибутов, которые точно её описывают. Например, для статьи это могут быть: «тема», «ключевые слова», «связанные продукты», «проблемы, которые решает», «целевая аудитория». Для продукта: «характеристики», «преимущества», «сценарии использования», «конкурентные отличия».
ИИ-системы не просто ищут слова, они ищут смысл. Если ваш контент не обладает четко выраженной смысловой структурой и не связан с другими сущностями, он будет невидимым для генеративного ИИ. Ваша задача — сделать бренд «понятным» для машины, как если бы вы объясняли его очень умному, но бесстрастному студенту.
— Алиса Ремезова, GEO/AEO-стратег
Регулярно проверяйте полноту и актуальность этих атрибутов. Устаревшая или неполная информация может привести к тому, что ИИ будет давать некорректные или неполные ответы, что негативно скажется на восприятии бренда.
Этапы формирования «цифрового атласа знаний»
Процесс создания атласа знаний можно разбить на несколько последовательных шагов, каждый из которых требует тщательной проработки.
1. Инвентаризация и аудит контента
Начните с полного аудита всего существующего контента: веб-сайта, блогов, документации, баз знаний, маркетинговых материалов. Определите, какая информация уже есть, в каком она формате и насколько актуальна. Выявите пробелы, противоречия и устаревшие данные. Оцените, какой контент можно использовать «как есть», а что требует доработки или переработки.
2. Разработка семантической модели и онтологии
На этом этапе формируются ключевые сущности бренда и их взаимосвязи. Это может быть как простая иерархическая структура, так и сложная графовая модель. Используйте инструменты для визуализации графов знаний, чтобы наглядно представить связи. Привлеките к этому процессу экспертов по продукту, маркетингу и поддержке клиентов, чтобы обеспечить полноту и точность.
3. Структурирование и разметка контента
После создания семантической модели переходите к структурированию самого контента. Переписывайте или адаптируйте тексты так, чтобы они содержали чёткие определения, ответы на вопросы, списки и пошаговые инструкции. Обязательно используйте разметку Schema.org на всех релевантных страницах. Убедитесь, что каждый факт, который вы хотите донести до ИИ, представлен в легкоизвлекаемом формате.
4. Интеграция и централизация данных
Соберите все структурированные данные в единую систему — это может быть внутренняя база знаний, CMS с возможностями семантического поиска или специализированная платформа для управления знаниями. Важно обеспечить возможность быстрого доступа и обновления этой информации. Идеально, если атлас будет интегрирован с системами управления продуктами, CRM и системами поддержки, чтобы информация всегда была актуальной.
5. Тестирование и оптимизация
После запуска атласа регулярно тестируйте его эффективность. Используйте различные ИИ-ассистенты и чат-боты, чтобы задавать вопросы о вашем бренде. Оценивайте точность и полноту ответов. Анализируйте пропущенные вопросы и некорректные интерпретации, чтобы выявить слабые места в атласе и доработать его. Это итерационный процесс: знания о бренде постоянно развиваются, и атлас должен развиваться вместе с ними.
Практический кейс: Разработка атласа знаний для технологической компании X
Технологическая компания X, разработчик SaaS-решений для автоматизации бизнес-процессов, столкнулась с проблемой: несмотря на богатый контент (блог, документация, FAQ), ИИ-ассистенты часто давали поверхностные или неточные ответы на вопросы о продукте. Пользователи жаловались, что приходится тратить много времени на поиск информации. Целью стало создание «цифрового атласа знаний» для улучшения AEO и GEO.
Реализация проекта
1. Инвентаризация: Провели аудит более 500 статей в блоге, 200 страниц документации и всех маркетинговых материалов. Выявили дублирование, устаревшую информацию и отсутствие четких определений для 30% ключевых терминов.
2. Семантическая модель: Определили 150+ ключевых сущностей (например, «CRM-система», «интеграция», «API», «модуль аналитики», «поддержка клиентов») и построили графовую модель их взаимосвязей. Например, «Модуль аналитики» связан с «CRM-системой» (как компонент), «Отчетами» (как результат) и «Принятием решений» (как цель).
3. Структурирование и разметка: Переписали все страницы продуктов, добавив четкие разделы «Что это?», «Для кого?», «Как работает?», «Преимущества», «Технические требования». Вся эта информация была размечена с помощью Schema.org, используя типы Product, HowTo, FAQPage, Organization. Создали глоссарий терминов, где каждое определение было размечено как Article или Definition.
4. Интеграция: Создали централизованную базу знаний на платформе Confluence, интегрированную с Jira для отслеживания обновлений. Ключевые данные из этой базы автоматически синхронизировались с публичным сайтом и внутренним чат-ботом поддержки.
Результаты
Через 6 месяцев после внедрения «цифрового атласа знаний» компания X зафиксировала следующие улучшения:
- Рост прямых ответов в ИИ-поиске на 40% по запросам, связанным с продуктами и их функционалом.
- Увеличение времени на сайте на страницах с подробным описанием функционала на 25%.
- Снижение обращений в службу поддержки, связанных с поиском информации, на 18%.
- Повышение конверсии на 7% для пользователей, взаимодействовавших с ИИ-ассистентом на сайте.
Кейс компании X наглядно демонстрирует, что инвестиции в «цифровой атлас знаний» приносят ощутимые бизнес-результаты, улучшая не только видимость в поиске, но и пользовательский опыт в целом.
Конкурентное преимущество сегодня — это не только качество продукта, но и качество информации о нём, доступное ИИ. Тот, кто инвестирует в создание системного атласа знаний, будет получать долю внимания в генеративных ответах, опережая соперников, чей контент ИИ не может 'понять'.
— Эксперт по AEO-оптимизации
Поддержка и развитие «цифрового атласа знаний»
Создание атласа — это не единоразовая задача, а непрерывный процесс. Информация о вашем бренде, продуктах и рынке постоянно меняется. Поэтому атлас должен регулярно обновляться и расширяться.
Мониторинг и аналитика
Используйте аналитические инструменты для отслеживания того, как ИИ-системы взаимодействуют с вашим контентом. Обращайте внимание на запросы, по которым ИИ дает неполные или неверные ответы. Это укажет на пробелы в вашем атласе или на необходимость уточнения существующих данных. Мониторинг трендов в поисковых запросах также поможет предвидеть будущие потребности пользователей и заранее обогащать атлас соответствующей информацией.
Культура управления знаниями
Внедрите в компании культуру управления знаниями. Каждый отдел — от разработки продукта до службы поддержки — должен осознавать свою роль в создании и актуализации информации. Централизованная команда или ответственное лицо должны координировать этот процесс, обеспечивая согласованность и стандартизацию данных.
Масштабирование атласа
По мере роста бизнеса и расширения продуктовой линейки, ваш атлас знаний будет увеличиваться. Важно изначально закладывать архитектуру, которая позволит легко добавлять новые сущности, связи и типы контента без нарушения общей структуры. Это может включать использование графовых баз данных, которые по своей природе хорошо подходят для хранения и запроса семантически связанных данных.
Выводы и рекомендации
Формирование «цифрового атласа знаний» — это не просто очередная задача в списке SEO-оптимизатора, а стратегическая необходимость для любого бренда, стремящегося к долгосрочной видимости и доверию в условиях доминирования ИИ-поиска. Это инвестиция в будущую архитектуру вашей информации.
- 1.Примите стратегическое решение о создании «цифрового атласа знаний», воспринимая его как ключевой актив бренда, а не просто набор контента.
- 2.Проведите глубокий аудит всего контента, выявите пробелы и несоответствия, чтобы создать единый «источник истины».
- 3.Разработайте детальную семантическую модель и онтологию бренда, определяя сущности и их взаимосвязи — это фундамент для понимания ИИ.
- 4.Систематически применяйте структурированную разметку Schema.org на всех релевантных страницах вашего сайта, делая информацию машиночитаемой.
- 5.Оптимизируйте контент для ИИ-поиска: используйте четкие определения, списки, таблицы и FAQ-формат, чтобы ИИ мог легко извлекать точные ответы.
- 6.Интегрируйте атлас с внутренними системами управления данными и обеспечьте его регулярное обновление, чтобы информация всегда была актуальной.
- 7.Регулярно тестируйте и анализируйте, как ИИ-ассистенты отвечают на вопросы о вашем бренде, постоянно дорабатывая и расширяя атлас.
Инструменты для создания и управления «цифровым атласом знаний»
Создание и эффективное управление «цифровым атласом знаний» требует не только методологии, но и подходящих технологических решений. Правильный выбор инструментов помогает автоматизировать процессы сбора, структурирования, разметки и интеграции данных, значительно ускоряя внедрение и повышая точность ответов, которые генерируют ИИ-системы. При выборе нужно ориентироваться на масштабы бренда, сложность контента и текущую ИТ-инфраструктуру.
Платформы для управления знаниями (Knowledge Management Systems, KMS)
KMS служат центральным репозиторием для всей корпоративной информации. Их функционал позволяет хранить, организовывать и распространять знания внутри компании, а в контексте атласа знаний — выступать основной базой для контентных сущностей. Такие системы предлагают инструменты для создания статей, документов, FAQ, а также функции поиска и классификации, которые помогают в дальнейшем семантическом обогащении данных. Часто они интегрируются с другими корпоративными системами, что упрощает сбор информации из разных источников.
Современные KMS поддерживают версионирование документов, управление доступом, а также интеграцию с инструментами для совместной работы. Это позволяет команде маркетологов, контент-менеджеров и ИТ-специалистов работать над атласом знаний совместно, обеспечивая актуальность и полноту данных. Некоторые KMS уже включают базовые возможности для семантической разметки или предоставляют API для интеграции со специализированными инструментами.
Инструменты для семантической разметки и онтологий
Для работы с семантическим ядром и онтологиями требуются более специализированные решения. Эти инструменты позволяют создавать и визуализировать сложные взаимосвязи между концептами, определять свойства сущностей и строить графы знаний. Они критически важны для формирования точных и контекстно-зависимых ответов ИИ, поскольку именно здесь устанавливается логика, по которой ИИ-ассистент будет понимать и сопоставлять информацию.
- Редакторы онтологий. Программы вроде Protégé позволяют строить сложные онтологические модели, определять классы, свойства и их взаимосвязи. Это настольные приложения, которые дают максимальный контроль над структурой знаний.
- Графовые базы данных. Neo4j, ArangoDB или Amazon Neptune хорошо подходят для хранения и запроса семантических данных. Они эффективно работают со сложными взаимосвязями и позволяют быстро извлекать связанные сущности, что ценно для ИИ-систем.
- Сервисы для разметки Schema.org. Существуют плагины для CMS (например, для WordPress), а также онлайн-инструменты, которые помогают генерировать микроразметку без глубоких знаний кода. Это ускоряет процесс внедрения структурированных данных.
Платформы для управления данными и интеграции (Data Management Platforms, DMP)
Когда речь идёт о бренде с большим количеством источников данных — от CRM-систем и систем аналитики до ERP и различных контентных платформ — DMP становятся незаменимыми. Они помогают агрегировать, очищать и стандартизировать данные из разрозненных источников, что является фундаментом для построения надёжного «цифрового атласа знаний». Без качественной интеграции данные останутся разрозненными и не смогут быть эффективно использованы ИИ.
DMP обеспечивают единое представление о клиенте и продукте, собирая всю доступную информацию в одном месте. Это включает не только структурированные данные, но и метаданные, которые затем могут быть использованы для обогащения контентных сущностей в атласе. Интеграция с инструментами аналитики также позволяет отслеживать, как часто и каким образом используется информация из атласа, помогая выявлять пробелы или неточности.
Вызовы и распространённые ошибки при формировании атласа знаний
Создание «цифрового атласа знаний» — это сложный, многоэтапный процесс, который часто сопровождается определёнными вызовами. Компании, которые впервые приступают к такой работе, рискуют совершить ошибки, замедляющие проект или снижающие его эффективность. Понимание этих подводных камней помогает заранее подготовиться и избежать типичных проблем.
Недооценка объёма и сложности контента
Бренды часто недооценивают масштаб контента, который необходимо инвентаризировать и структурировать. Накопленные за годы веб-страницы, статьи, продуктовые описания, FAQ, маркетинговые материалы, обучающие пособия — всё это представляет собой огромный массив данных. Попытка охватить всё сразу без чёткого плана и приоритизации приводит к перегрузке команды и затягиванию сроков.
Ошибка здесь кроется в отсутствии детального аудита контента на начальном этапе. Без него невозможно понять, какой контент действительно актуален, какой требует доработки, а какой можно удалить. Это приводит к разметке устаревших или нерелевантных данных, что, в свою очередь, сказывается на качестве ответов ИИ. Всегда начинайте с тщательной ревизии и сегментации контента.
Отсутствие единой семантической модели
Без чётко определённого семантического ядра и онтологий «цифровой атлас знаний» становится просто хранилищем информации, а не источником осмысленных связей. Если разные отделы или команды используют собственную терминологию или по-разному интерпретируют ключевые понятия, то ИИ-система не сможет эффективно сопоставлять данные и выдавать согласованные ответы.
«Семантическая согласованность — это краеугольный камень любого эффективного атласа знаний. Без неё вы получите не картину мира бренда, а набор разрозненных пазлов, которые ИИ не сможет собрать воедино. Инвестиции в разработку онтологии окупаются многократно.»
— Доктор Анна Смирнова, эксперт по управлению знаниями
Проблема усугубляется, если в процесс создания семантической модели не вовлечены ключевые стейкхолдеры из разных подразделений. Каждое подразделение владеет уникальными знаниями о продуктах, клиентах или процессах. Их участие помогает создать всеобъемлющую и точную модель, которая отражает реальное положение дел в компании.
Недостаточное внимание к тестированию и оптимизации
Многие команды воспринимают создание атласа как одноразовый проект. Они размечают контент, интегрируют данные и считают работу завершённой. Однако «цифровой атлас знаний» — это живая система, которая требует постоянного мониторинга, тестирования и итеративной оптимизации. Без этого данные быстро устаревают, а качество ответов ИИ снижается.
- Отсутствие регулярных проверок. Необходимо постоянно проверять, как ИИ-ассистенты используют данные из атласа, какие вопросы остаются без ответа или на какие даются неточные ответы. Это позволяет выявить пробелы в контенте или ошибках в разметке.
- Игнорирование обратной связи. Важно собирать обратную связь от пользователей ИИ-систем (как внутренних, так и внешних) и использовать её для улучшения атласа. Это могут быть запросы, которые не были поняты, или ситуации, когда ответ оказался неполным.
- Забытый «цикл жизни» контента. Контент меняется: появляются новые продукты, обновляются услуги, устаревают старые инструкции. Атлас должен отражать эти изменения. Нужно внедрить процессы регулярного обновления, иначе ИИ будет оперировать устаревшей информацией.
Комплексный подход, включающий регулярный аудит, тестирование и непрерывное улучшение, — залог долгосрочной эффективности «цифрового атласа знаний».


Комментарии (0)
Без регистрации. Комментарии проверяются автоматически перед публикацией.
Пока нет комментариев. Будьте первым!